
고가용성 클러스터 기반 배포
Enterprise, Enterprise Advanced 플랜에서 사용할 수 있습니다.
고가용성 클러스터 기반 배포를 사용하면 중복 인프라를 통해 장애와 하드웨어 고장이 발생하는 동안에도 Mattermost 시스템이 서비스를 유지할 수 있습니다.
Mattermost의 고가용성은 중복 Mattermost 애플리케이션 서버, 중복 데이터베이스 서버, 중복 로드 밸런서를 운영하는 것을 말합니다. 이들 구성 요소 중 어느 하나에 장애가 발생해도 시스템 운영은 중단되지 않습니다.
Mattermost Enterprise는 다음을 지원합니다.
- 클러스터화된 Mattermost 서버. 다음 방식으로 지연을 최소화합니다.
- 정적 자산을 글로벌 CDN에 저장합니다.
- 여러 대의 Mattermost 서버를 배포해 최종 사용자 위치에 더 가까운 곳에서 API 통신을 처리합니다.
재해 복구 시나리오에서 규모 처리와 장애 인계에도 사용할 수 있습니다.
- 데이터베이스 읽기 복제본. 복제본은 다음과 같이 활용할 수 있습니다.
- 활성 데이터베이스 서버의 중복 백업으로 구성합니다.
- 동시 접속 사용자 수를 늘리는 데 사용합니다.
- 최종 사용자 위치에 더 가깝게 배포해 지연을 줄입니다.
또한 검색 쿼리를 처리하기 위한 검색 복제본도 지원됩니다.
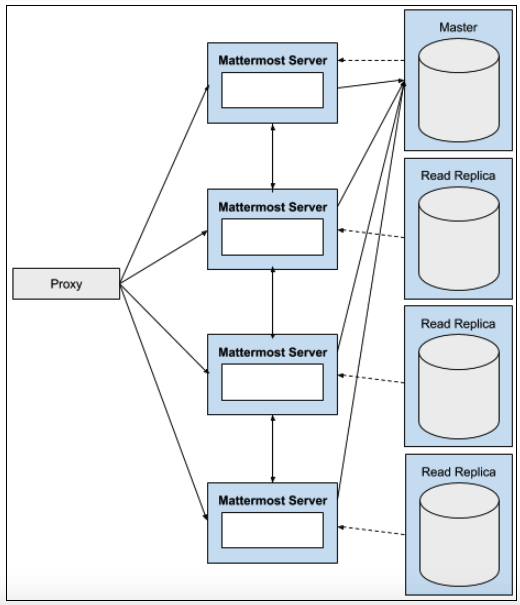
준비
- 해당 사용자 수에 맞게 Mattermost를 확장하는 지침은 사용 가능한 참조 아키텍처를 검토하세요. 참조 아키텍처 지침에는 Mattermost 노드, 데이터베이스 라이터·리더 노드, Elasticsearch 노드, 프록시 노드의 권장 수와 예상 사용 패턴에 따른 파일 스토리지 추정치가 포함됩니다.
- Mattermost의 파일 스토리지 구성을 Amazon S3, S3 호환 파일 스토리지 서비스, 또는 각 Mattermost 노드에 마운트한 네트워크 연결 스토리지(NAS) 중 무엇으로 할지 결정하세요. Mattermost 노드가 NAS 위치가 아니라 각 노드의 호스트 파일 시스템에 있는 로컬 파일 시스템 스토리지로 구성된 채로 남아 있으면 고가용성이 올바르게 동작하지 않고 파일 스토리지가 손상될 수 있습니다.
- Kubernetes 배포는 Kubernetes에 Mattermost 배포를 검토하세요.
- Kubernetes가 아닌 배포에서는 Mattermost용으로 준비한 서버 한 대에 원하는 버전의 Mattermost를 설치하거나 업그레이드하세요. 설치 세부 사항은 Linux에 Mattermost 배포를 참고하세요. 설치한 노드에 Enterprise 또는 Enterprise Advanced 라이선스 키를 적용하려면 라이선스 키 설치를 참고하세요.
- 권장: Mattermost 구성에
config.json을 사용하고 있다면 데이터베이스에 구성 저장을 참고해 Mattermost 인스턴스가 구성에 데이터베이스를 사용하도록 마이그레이션하세요.config.json파일을 계속 사용할 수도 있습니다. 다만 고가용성이 활성화되면 Mattermost 서버의 모든config.json파일이 항상 동일하도록 보장하기 위해 시스템 콘솔이 읽기 전용 모드로 설정됩니다. - 적절한 규모의 Calls 배포 계획을 세우려면 Calls 자체 호스팅 배포를 검토하세요.
- Mattermost 서버의 게시물이 250만 건을 넘을 것으로 예상된다면 최적의 검색 성능을 확보하기 위한 옵션을 엔터프라이즈 검색에서 검토하세요.
- 사용자 100,000명 이상 규모의 Mattermost 배포에서는 Redis 배포 가이드를 검토하세요.
배포 가이드
Mattermost 서버에 고가용성 클러스터 기반 배포를 구성하고 유지·관리하세요.
고가용성을 구성하기 전에 Mattermost 데이터베이스와 파일 스토리지 위치를 백업하세요. 백업에 대한 자세한 내용은 백업 및 재해 복구를 참고하세요.
Mattermost 서버
권장: 클러스터의 모든 서버에서 구성 관리를 단순화하려면
config.json대신 데이터베이스에 구성을 저장하세요.추가 Mattermost 서버 설정: 현재 배포와 동일한 구성으로 Mattermost 서버를 추가로 준비합니다.
- Kubernetes 배포:
mattermost-installation.yaml파일의spec섹션에 있는replicas필드를 원하는 서버 수로 변경한 뒤(예: 2대 클러스터라면replicas: 2),kubectl apply -f mattermost-installation.yaml로 변경된 매니페스트를 적용합니다. - Kubernetes가 아닌 배포: Linux에 Mattermost 배포 지침에 따라 추가 서버마다 동일한 버전의 Mattermost를 설치합니다.
구성을 데이터베이스에 저장한다면 각 서버의
MM_CONFIG환경 변수가 동일한 데이터베이스 연결 문자열을 가리키도록 하세요.config.json파일을 사용한다면 각 서버가 동일한 사본을 갖도록 하세요.- Kubernetes 배포:
시스템 한계 구성: 각 Mattermost 서버에서 프로세스 한계를 8192로, 최대 열린 파일 수를 65536으로 설정합니다.
리소스 한계를 설정하도록 systemd 서비스 파일을 편집합니다.
sudo sed -i '/\[Service\]/a LimitNOFILE=65536\nLimitNPROC=8192' /etc/systemd/system/mattermost.service직접 편집하고 싶다면
/etc/systemd/system/mattermost.service의[Service]섹션에 다음 줄을 추가합니다.[Service] LimitNOFILE=65536 LimitNPROC=8192한계를 적용하려면 systemd를 다시 로드하고 서비스를 재시작합니다.
sudo systemctl daemon-reload
sudo systemctl restart mattermost
한계가 적용되었는지 확인합니다.
# Check the actual process limits
cat /proc/$(pgrep -f mattermost | head -1)/limits | grep -E "Max open files|Max processes"
Max open files가 65536으로 설정되어 있어야 합니다.네트워크 설정 최적화: 각 Mattermost 서버에서 WebSocket 연결 한계를 늘리고 TCP 설정을 최적화하도록 커널 파라미터를 구성합니다.
Mattermost용 sysctl 구성 파일을 생성합니다.
sudo tee /etc/sysctl.d/mattermost.conf > /dev/null <<EOF
# Extending default port range to handle lots of concurrent connections.
net.ipv4.ip_local_port_range = 1025 65000

# Lowering the timeout to faster recycle connections in the FIN-WAIT-2 state.
net.ipv4.tcp_fin_timeout = 30

# Reuse TIME-WAIT sockets for new outgoing connections.
net.ipv4.tcp_tw_reuse = 1

# Bumping the limit of a listen() backlog.
# This is maximum number of established sockets (with an ACK)
# waiting to be accepted by the listening process.
net.core.somaxconn = 4096

# Increasing the maximum number of connection requests which have
# not received an acknowledgment from the client.
# This is helpful to handle sudden bursts of new incoming connections.
net.ipv4.tcp_max_syn_backlog = 8192

# This is tuned to be 2% of the available memory.
vm.min_free_kbytes = 167772

# Disabling slow start helps increasing overall throughput
# and performance of persistent single connections.
net.ipv4.tcp_slow_start_after_idle = 0

# These show a good performance improvement over defaults.
# More info at https://blog.cloudflare.com/http-2-prioritization-with-nginx/
net.ipv4.tcp_congestion_control = bbr
net.core.default_qdisc = fq
net.ipv4.tcp_notsent_lowat = 16384

# TCP buffer sizes are tuned for 10Gbit/s bandwidth and 0.5ms RTT (as measured intra EC2 cluster).
# This gives a BDP (bandwidth-delay-product) of 625000 bytes.
# The maximum socket buffer size for kernel autotuning is set to be 4x the BDP (2500000).
# The default socket buffer size is set to 1/4 BDP (156250).
net.ipv4.tcp_rmem = 4096 156250 2500000
net.ipv4.tcp_wmem = 4096 156250 2500000

# Bumping the theoretical maximum buffer size of receiving/sending sockets,
# either UDP, or TCP not using autotuning (i.e. using SO_RCVBUF)
net.core.rmem_max = 16777216
net.core.wmem_max = 16777216
EOF
설정을 즉시 적용합니다.
sudo sysctl -p /etc/sysctl.d/mattermost.conf시간 동기화 활성화: 메시지가 올바른 순서로 게시되고 클러스터 통신이 정상 동작하려면 클러스터의 각 서버가 시간을 동기화해야 합니다.
Ubuntu/Debian:
최신 Ubuntu 시스템은 기본적으로
systemd-timesyncd를 사용하며 대개 이미 활성화되어 있습니다. 시간 동기화가 동작하는지 확인합니다.timedatectl statusSystem clock synchronized: yes가 표시되어야 합니다. 시간 동기화가 활성화되어 있지 않다면 다음으로 활성화합니다.sudo timedatectl set-ntp trueRHEL/CentOS/Rocky Linux:
sudo dnf install chrony
sudo systemctl enable chronyd
sudo systemctl start chronyd
시간 동기화가 동작하는지 확인합니다.
chronyc sources개별 서버 동작 확인: 클러스터링을 활성화하기 전에 각 서버의 사설 IP 주소로 직접 접속해 서버가 단독으로 정상 동작하는지 확인합니다.
각 Mattermost 서버의 사설 IP 주소를 확인합니다.
# Get all IP addresses for the server
hostname -I

# Or get the primary network interface IP
ip addr show | grep "inet " | grep -v 127.0.0.1 | awk '{print $2}' | cut -d/ -f1
사설 IP 주소로 각 서버에서 Mattermost에 접근할 수 있는지 테스트합니다.
# Replace with your server's actual IP address
curl http://192.168.1.10:8065
Mattermost 애플리케이션의 HTML 출력이 보여야 합니다. 클러스터의 모든 Mattermost 서버에 대해 이 확인을 반복하세요.
클러스터 설정 구성:
ClusterSettings섹션을 구성해 고가용성을 활성화합니다. mmctl을 사용해 클러스터 설정을 지정합니다.mmctl config set ClusterSettings.Enable true mmctl config set ClusterSettings.ClusterName production mmctl config set ClusterSettings.UseIPAddress true mmctl config set ClusterSettings.GossipPort 8074구성을 데이터베이스가 아니라
config.json에 저장하고 있다면, 시스템 콘솔 변경이 한 노드의config.json에만 기록되어 다른 노드와 어긋나는 일을 막기 위해ClusterSettings.ReadOnlyConfig도true로 설정하세요.mmctl config set ClusterSettings.ReadOnlyConfig true구성을 데이터베이스에 저장한 경우(데이터베이스에 구성 저장 참고)에는 모든 노드가 공유 데이터베이스에서 동일한 구성을 읽으므로
ClusterSettings.ReadOnlyConfig는 무시됩니다.비표준 네트워크 구성을 위한
OverrideHostname을 포함해 사용 가능한 모든 클러스터 설정에 대한 자세한 내용은 고가용성 설정 문서를 참고하세요.Mattermost 서버 재시작: 새 구성을 적용하려면 클러스터의 각 Mattermost 서버를 재시작합니다.
sudo systemctl restart mattermost클러스터 통신 확인: System Console > Environment > High Availability(시스템 콘솔 > 환경 > 고가용성)를 열어 클러스터의 각 서버가 초록색 상태 표시와 함께 정상적으로 통신하는지 확인합니다. 그렇지 않다면 로그 파일에서 추가 정보를 확인하세요.
프록시 서버
프록시 서버는 Mattermost 서버 클러스터를 외부 클라이언트에 노출합니다. 프록시는 클러스터의 모든 Mattermost 서버로 트래픽을 분산하고, 상태 점검을 통해 정상 서버로만 트래픽을 라우팅합니다.
Mattermost는 다양한 로드 밸런싱 솔루션과 함께 동작하도록 설계되었습니다.
- 소프트웨어 프록시: NGINX
- 클라우드 로드 밸런서: Amazon Elastic Load Balancer(ELB/ALB), Azure Load Balancer, Google Cloud Load Balancing
- 하드웨어 로드 밸런서: F5 BIG-IP, Citrix NetScaler ADC 및 기타 엔터프라이즈 솔루션
이 섹션에서는 가장 널리 쓰이는 NGINX의 구성 방법을 설명합니다. 클라우드 로드 밸런서나 하드웨어 로드 밸런서를 사용한다면 /api/v4/system/ping 엔드포인트에 대한 상태 점검과 여러 백엔드 서버에 대한 로드 밸런싱 구성 방법을 해당 제공업체 문서에서 확인하세요.
자세한 NGINX 구성은 NGINX 프록시 설정을 참고하세요. 이 섹션은 고가용성에 특화된 구성에 초점을 맞추지만, 전체 프록시 문서에는 프로덕션 배포에 중요한 추가 최적화와 설정이 담겨 있습니다.
대규모 배포의 경우 NGINX 프록시 문서에는 워커 프로세스 설정, 연결 한계, keepalive 최적화 등 성능에 결정적인 메인 구성 최적화(/etc/nginx/nginx.conf)가 추가로 포함되어 있습니다. 이 필수 설정들은 프록시 문서의 NGINX 메인 구성 최적화 섹션을 참고하세요.
NGINX 설치: 프록시 서버에 NGINX를 설치합니다.
Ubuntu/Debian:
sudo apt update
sudo apt install nginx
RHEL/CentOS:
sudo dnf install nginx고가용성 백엔드 구성: 고가용성 배포에 최적화된 고성능 설정으로 클러스터의 모든 Mattermost 서버를 정의하는 NGINX 구성을 만듭니다.
환경에 맞게 구성 변수를 설정합니다.
# Ubuntu/Debian: Use sites-available directory
NGINX_CONF="/etc/nginx/sites-available/mattermost"

# RHEL/CentOS: Use conf.d directory instead
# NGINX_CONF="/etc/nginx/conf.d/mattermost.conf"

# Set your Mattermost server IP addresses
MM_SERVER_1="192.168.1.10"
MM_SERVER_2="192.168.1.11"

# Set your domain name
MM_DOMAIN="mattermost.example.com"
고성능 설정을 담은 NGINX 구성 파일을 생성합니다.
sudo tee "$NGINX_CONF" > /dev/null <<EOF
upstream backend {
      server ${MM_SERVER_1}:8065 max_fails=0;
      server ${MM_SERVER_2}:8065 max_fails=0;
      keepalive 256;
}

proxy_cache_path /var/cache/nginx levels=1:2 keys_zone=mattermost_cache:10m max_size=3g inactive=120m use_temp_path=off;

server {
  listen 80 reuseport;
  server_name ${MM_DOMAIN};

  location ~ /api/v[0-9]+/(users/)?websocket$ {
        proxy_set_header Upgrade \$http_upgrade;
        proxy_set_header Connection "upgrade";
        client_max_body_size 50M;
        proxy_set_header Host \$http_host;
        proxy_set_header X-Real-IP \$remote_addr;
        proxy_set_header X-Forwarded-For \$proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto \$scheme;
        proxy_set_header X-Frame-Options SAMEORIGIN;
        proxy_buffers 256 16k;
        proxy_buffer_size 16k;
        client_body_timeout 60s;
        send_timeout        300s;
        lingering_timeout   5s;
        proxy_connect_timeout   90s;
        proxy_send_timeout      300s;
        proxy_read_timeout      90s;
        proxy_http_version 1.1;
        proxy_pass http://backend;
  }

  location ~ /api/v[0-9]+/users/[a-z0-9]+/image\$ {
        proxy_set_header Connection "";
        client_max_body_size 50M;
        proxy_set_header Host \$http_host;
        proxy_set_header X-Real-IP \$remote_addr;
        proxy_set_header X-Forwarded-For \$proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto \$scheme;
        proxy_set_header X-Frame-Options SAMEORIGIN;
        proxy_buffers 256 16k;
        proxy_buffer_size 16k;
        proxy_read_timeout 600s;
        proxy_http_version 1.1;
        proxy_pass http://backend;
        proxy_cache mattermost_cache;
        proxy_cache_revalidate on;
        proxy_cache_min_uses 2;
        proxy_cache_use_stale timeout;
        proxy_cache_lock on;
        proxy_ignore_headers Cache-Control Expires;
        proxy_cache_valid 200 24h;
  }

  location / {
        proxy_set_header Connection "";
        client_max_body_size 50M;
        proxy_set_header Host \$http_host;
        proxy_set_header X-Real-IP \$remote_addr;
        proxy_set_header X-Forwarded-For \$proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto \$scheme;
        proxy_set_header X-Frame-Options SAMEORIGIN;
        proxy_buffers 256 16k;
        proxy_buffer_size 16k;
        proxy_read_timeout 600s;
        proxy_http_version 1.1;
        proxy_pass http://backend;
        proxy_cache mattermost_cache;
        proxy_cache_revalidate on;
        proxy_cache_min_uses 2;
        proxy_cache_use_stale timeout;
        proxy_cache_lock on;
  }
}
EOF
이 구성에는 서버가 사용 불가로 표시되는 것을 방지하는 설정(
max_fails=0), 24시간 동안의 사용자 이미지 캐싱, 장시간 실행 작업을 위한 타임아웃 연장 같은 고성능 최적화가 포함되어 있습니다. 워커 프로세스 최적화와 고급 버퍼 설정을 포함한 추가 NGINX 성능 튜닝 옵션은 고성능 확장 구성 섹션을 참고하세요.사이트 구성 활성화:
Ubuntu/Debian:
sudo ln -sf /etc/nginx/sites-available/mattermost /etc/nginx/sites-enabled/mattermost
sudo rm -f /etc/nginx/sites-enabled/default
RHEL/CentOS:
/etc/nginx/conf.d/에 있는 구성 파일은 자동으로 활성화됩니다.NGINX 구성 테스트 및 적용:
sudo nginx -t
sudo systemctl restart nginx
sudo systemctl enable nginx
TLS 구성: 프로덕션 배포에서는 NGINX 프록시에 TLS를 구성하세요. NGINX로 TLS를 구성하는 자세한 방법은 TLS 설정을 참고하세요. Let's Encrypt로 인증서를 자동 관리하거나 직접 준비한 TLS 인증서를 사용할 수 있습니다.
상태 점검 구성: 위의 upstream 블록은
max_fails=0을 설정하여 NGINX의 수동 격리를 비활성화합니다. 즉 실패한 요청 수를 근거로 백엔드를 사용 불가로 표시하지 않습니다. 개별 실패 요청은 NGINX의 기본proxy_next_upstream동작에 따라 여전히 다른 백엔드로 재시도됩니다. 장애가 발생한 서버를 감지해 로테이션에서 제외하려면 로드 밸런서나 모니터링 시스템의 능동적 상태 점검을 사용해 Mattermost API 엔드포인트http://SERVER_IP:8065/api/v4/system/ping(정상 서버는Status 200을 반환)을 모니터링하세요.프록시 동작 확인: 구성한 도메인 이름으로 프록시를 통해 접속해 보고, Mattermost 서버 로그를 확인해 트래픽이 백엔드 서버들에 분산되는지 검증합니다.
파일 스토리지
고가용성 배포에서는 클러스터의 모든 Mattermost 서버가 동일한 파일 스토리지에 접근할 수 있어야 합니다. 각 서버의 로컬 파일 시스템 스토리지는 HA에서 올바르게 동작하지 않으며 파일 스토리지를 손상시킬 수 있습니다.
고가용성에서 지원되는 파일 스토리지 옵션:
- Amazon S3 또는 S3 호환 오브젝트 스토리지(권장)
- NFS 등의 프로토콜을 사용하는 네트워크 연결 스토리지(NAS)
현재 로컬 파일 시스템 스토리지(로컬 디렉터리와 함께 "DriverName": "local")를 사용하고 있다면, 고가용성을 활성화하기 전에 공유 스토리지로 마이그레이션해야 합니다. 각 노드의 로컬 스토리지로 HA를 운영하면 파일 손상과 데이터 유실이 발생할 수 있습니다.
S3 또는 S3 호환 스토리지 구성
Amazon S3와 S3 호환 스토리지 솔루션(MinIO, Digital Ocean Spaces 등)은 고가용성 배포에 권장되는 파일 스토리지 옵션입니다.
파일 스토리지 설정 구성: mmctl 또는 시스템 콘솔을 사용해 S3 스토리지를 구성합니다.
# Set storage driver to S3
mmctl config set FileSettings.DriverName amazons3

# Configure S3 bucket and region
mmctl config set FileSettings.AmazonS3Bucket your-bucket-name
mmctl config set FileSettings.AmazonS3Region us-east-1

# Configure S3 credentials (if not using IAM roles)
mmctl config set FileSettings.AmazonS3AccessKeyId your-access-key-id
mmctl config set FileSettings.AmazonS3SecretAccessKey your-secret-access-key
S3 호환 스토리지(MinIO 등)를 사용한다면 엔드포인트도 구성합니다.
mmctl config set FileSettings.AmazonS3Endpoint s3.your-domain.com구성 확인: Mattermost를 재시작하고 파일 업로드를 테스트해 파일이 S3에 올바르게 저장되는지 확인합니다.
사용 가능한 모든 S3 구성 옵션의 자세한 내용은 파일 스토리지 설정 문서를 참고하세요.
NFS 공유 스토리지 구성
Amazon S3나 S3 호환 스토리지의 대안으로, NFS를 사용하는 네트워크 연결 스토리지(NAS)를 통해 모든 Mattermost 서버가 네트워크로 동일한 파일 디렉터리에 접근할 수 있습니다.
사용자 ID 일치 확인:
mattermost사용자는 NFS 서버와 모든 Mattermost 서버에서 UID와 GID가 동일해야 합니다.Mattermost 서버에서 UID/GID를 확인합니다.
id mattermost출력은
uid=500(mattermost) gid=500(mattermost)와 같은 형태입니다. 이 값을 기록해 두세요.NFS 서버에서 동일한 UID/GID로
mattermost사용자를 만듭니다(500은 실제 값으로 바꾸세요).sudo useradd -r -U -u 500 -M -d /opt/mattermost -s /bin/bash mattermost사용자가 이미 다른 UID로 존재한다면 다음을 실행합니다.
sudo usermod -u 500 mattermost
sudo groupmod -g 500 mattermost
NFS 서버 설정: NFS 서버 패키지를 설치하고 공유 디렉터리를 구성합니다.
Ubuntu/Debian:
sudo apt update
sudo apt install nfs-kernel-server
RHEL/CentOS/Rocky Linux:
sudo dnf install nfs-utilsmattermost소유로 공유 디렉터리를 만듭니다.sudo mkdir -p /mnt/mattermost-data sudo chown mattermost:mattermost /mnt/mattermost-data sudo chmod 755 /mnt/mattermost-data/etc/exports에 항목을 추가합니다.NETWORK/CIDR은 사용 중인 네트워크 대역(예:192.168.1.0/24)으로 바꾸고mattermostUID/GID 값을 사용하세요./mnt/mattermost-data NETWORK/CIDR(rw,sync,anonuid=500,anongid=500)예시:
# For subnet 192.168.1.0/24
/mnt/mattermost-data 192.168.1.0/24(rw,sync,anonuid=500,anongid=500)

# For specific servers only
/mnt/mattermost-data 192.168.1.10(rw,sync,anonuid=500,anongid=500) 192.168.1.11(rw,sync,anonuid=500,anongid=500)
NFS 서버를 활성화하고 시작합니다.
Ubuntu/Debian:
sudo systemctl enable --now nfs-kernel-server
sudo exportfs -arv
RHEL/CentOS/Rocky Linux:
sudo systemctl enable --now nfs-server
sudo exportfs -arv
필요하다면 방화벽을 구성합니다.
Ubuntu/Debian:
sudo ufw allow from NETWORK/CIDR to any port nfsRHEL/CentOS/Rocky Linux:
sudo firewall-cmd --permanent --add-service=nfs
sudo firewall-cmd --permanent --add-service=mountd
sudo firewall-cmd --permanent --add-service=rpc-bind
sudo firewall-cmd --reload
Mattermost 서버에 NFS 마운트: NFS 클라이언트 패키지를 설치하고 각 Mattermost 서버에 공유를 마운트합니다.
Ubuntu/Debian:
sudo apt update
sudo apt install nfs-common
sudo mkdir -p /opt/mattermost/data
sudo mount -t nfs -o rw,hard NFS_SERVER_IP:/mnt/mattermost-data /opt/mattermost/data
RHEL/CentOS/Rocky Linux:
sudo dnf install nfs-utils sudo mkdir -p /opt/mattermost/data sudo mount -t nfs -o rw,hard NFS_SERVER_IP:/mnt/mattermost-data /opt/mattermost/dataNFS_SERVER_IP는 NFS 서버의 IP 주소로 바꾸세요.마운트가 올바른 소유권으로 표시되는지 확인합니다.
df -h /opt/mattermost/data
ls -ld /opt/mattermost/data
자동 마운트 구성: 각 Mattermost 서버의
/etc/fstab에 다음을 추가합니다.NFS_SERVER_IP:/mnt/mattermost-data /opt/mattermost/data nfs rw,hard 0 0예시:
192.168.1.100:/mnt/mattermost-data /opt/mattermost/data nfs rw,hard 0 0참고hard옵션은 NFS가 복구될 때까지 I/O 작업을 차단하여, 일시적인 네트워크나 NFS 서버 장애 중에 발생할 수 있는 부분 쓰기와 파일 손상을 방지합니다. 배포 환경에서 데이터 무결성보다 가용성이 더 중요하다면soft를 사용해 작업이 타임아웃되도록 할 수 있지만, 이 경우 일시적인 문제가 발생하는 동안 Mattermost에 I/O 오류가 반환되고 파일 손상 위험이 있으므로 공유 애플리케이션 데이터에는 권장하지 않습니다.파일 접근 테스트: 각 서버에서 쓰기 권한을 확인합니다.
sudo -u mattermost touch /opt/mattermost/data/test-$(hostname)
ls -l /opt/mattermost/data/
모든 서버에서
mattermost:mattermost소유의 파일이 보여야 합니다.Mattermost 구성: 파일 스토리지 디렉터리를 설정합니다.
sudo -u mattermost /opt/mattermost/bin/mmctl --local config set FileSettings.Directory /opt/mattermost/dataMattermost 재시작: 모든 서버에 구성을 적용합니다.
sudo systemctl restart mattermost확인: Mattermost가 공유 스토리지에 디렉터리를 생성하는지 확인합니다.
ls -la /opt/mattermost/data/users,teams같은 디렉터리가 보여야 합니다. 파일 업로드를 테스트해 모든 서버에서 파일에 접근할 수 있는지 확인하세요.
로컬 스토리지에서 공유 스토리지로 마이그레이션
기존 파일을 로컬 스토리지에서 S3나 NFS로 마이그레이션해야 한다면, 그 절차는 이 문서의 범위를 벗어납니다. 다만 일반적인 접근 방식은 다음과 같습니다.
- 새 공유 스토리지(S3 또는 NFS)를 설정합니다
- 로컬 디렉터리(보통
/opt/mattermost/data)의 모든 파일을 새 스토리지 위치로 복사합니다 - Mattermost 구성이 새 스토리지를 가리키도록 업데이트합니다
- 모든 파일에 접근할 수 있는지 확인합니다
데이터베이스
고가용성 배포에서는 최적의 성능과 안정성을 확보하기 위해 데이터베이스를 세심하게 구성해야 합니다. Mattermost는 데이터베이스 부하를 분산하는 읽기 복제본과 검색 쿼리를 분리하는 검색 복제본을 지원합니다.
PostgreSQL 설정은 프로덕션 안정성에 매우 중요합니다
아래에 설명하는 PostgreSQL 설정, 특히 읽기 복제본의 hot_standby와 hot_standby_feedback은 프로덕션 장애를 예방하는 데 필수적입니다. 이 설정들을 올바르게 구성하지 않으면 대규모 배포에서 장애가 발생합니다. 이 설정들은 주 데이터베이스의 쓰기 트래픽이 많을 때 읽기 복제본이 쿼리를 강제 종료하게 만드는 쿼리 충돌을 방지합니다.
또한 잘못된 연결 풀 설정, 누락된 배큐밍 구성, 최적화되지 않은 메모리 설정은 성능과 안정성을 크게 해칠 수 있습니다. 프로덕션에 배포하기 전에 권장 설정을 모두 검토하고 적용하세요.
데이터베이스 쿼리 분산 이해하기
Mattermost는 다음과 같이 데이터베이스 인프라 전반에 쿼리를 분산합니다.
- 쓰기 요청과 일부 특정 읽기 요청은 주 데이터베이스로 전송됩니다
- 읽기 요청(반드시 주 데이터베이스로 가야 하는 것 제외)은 사용 가능한 읽기 복제본에 분산됩니다. 읽기 복제본이 구성되어 있지 않으면 주 데이터베이스로 전송됩니다
- 검색 요청은 사용 가능한 검색 복제본에 분산됩니다. 검색 복제본이 구성되어 있지 않으면 읽기 복제본으로 전송되고, 읽기 복제본도 없으면 주 데이터베이스로 전송됩니다
모든 데이터베이스 구성 옵션에 대한 자세한 내용은 데이터베이스 설정 문서를 참고하세요.
Amazon RDS Aurora PostgreSQL
Amazon Aurora PostgreSQL은 고가용성과 자동 장애 조치 기능이 내장된 관리형 데이터베이스 서비스를 제공합니다.
아키텍처 개요:
- Aurora는 가용 영역에 걸쳐 여러 복제본을 자동으로 유지합니다
- 클러스터는 현재 주 인스턴스를 자동으로 가리키는 단일 라이터 엔드포인트를 제공합니다
- 클러스터는 사용 가능한 읽기 복제본에 부하를 분산하는 리더 엔드포인트를 제공합니다
- Aurora는 필요할 때 복제본을 주 인스턴스로 승격하며 자동 장애 조치를 처리합니다
Aurora용 Mattermost 구성:
주 데이터베이스 연결 구성: DataSource가 Aurora 클러스터의 라이터 엔드포인트를 가리키도록 설정합니다(개별 인스턴스 엔드포인트가 아닙니다).
# Use the cluster writer endpoint for the primary connection mmctl config set SqlSettings.DataSource "postgres://username:password@your-cluster.cluster-xxxxx.region.rds.amazonaws.com:5432/mattermost?sslmode=require&connect_timeout=10"중요인스턴스별 엔드포인트가 아니라 항상 클러스터 수준의 라이터 엔드포인트를 사용하세요. 그래야 Aurora가 DNS 엔드포인트를 새 주 인스턴스로 갱신하여 장애 조치를 자동으로 처리할 수 있습니다.
읽기 복제본 구성: 리더 엔드포인트가 아니라 개별 리더 인스턴스 엔드포인트를 직접 가리키도록 설정합니다. 구성 패치 파일을 만듭니다.
# Create a configuration patch file cat > /tmp/replica-config.json <<'EOF' { "SqlSettings": { "DataSourceReplicas": [ "postgres://username:password@your-cluster-instance-1.xxxxx.region.rds.amazonaws.com:5432/mattermost?sslmode=require&connect_timeout=10", "postgres://username:password@your-cluster-instance-2.xxxxx.region.rds.amazonaws.com:5432/mattermost?sslmode=require&connect_timeout=10" ] } } EOF # Apply the configuration mmctl config patch /tmp/replica-config.json # Clean up the temporary file rm /tmp/replica-config.json참고Aurora 리더 엔드포인트가 아니라 개별 리더 인스턴스 엔드포인트를 사용하세요. Mattermost는 읽기 쿼리에 대한 자체 로드 밸런싱 로직을 갖추고 있으며, 리더 인스턴스를 사용할 수 없게 되면 주 연결로 장애 조치할 수 있습니다.
연결 풀 설정 구성:
# Set connection pool limits (per database connection)
mmctl config set SqlSettings.MaxOpenConns 100
mmctl config set SqlSettings.MaxIdleConns 50
권장 비율은 2:1(MaxOpenConns:MaxIdleConns)입니다. 이 설정은 클러스터 전체 합계가 아니라 데이터 소스별, Mattermost 서버 노드별로 적용됩니다. 각 노드는 주 데이터베이스와 각 읽기 복제본·검색 복제본마다
MaxOpenConns크기의 자체 연결 풀을 엽니다.데이터베이스(또는 그 앞단의 연결 풀링 프록시)의
max_connections크기를 산정하려면 먼저 노드당 데이터 소스 수를 세세요. 주 데이터베이스가 1개이고 여기에 읽기 복제본 수와 검색 복제본 수를 더합니다. 그 수에MaxOpenConns를 곱하고, 다시 앱 서버 노드 수를 곱합니다.MaxOpenConnsx (노드당 데이터 소스 수) x (앱 노드 수)예를 들어 주 데이터베이스 1개와 읽기 복제본 2개가 있으면 각 노드의 데이터 소스는 3개입니다. 3노드 클러스터에서 기본
MaxOpenConns값 100을 적용하면 3 x 3 x 100 = 900개의 연결이 가능합니다.데이터베이스 구성 확인: Mattermost를 재시작하고 데이터베이스 연결이 정상인지 확인합니다.
sudo systemctl restart mattermost

# Check logs for database connection messages
sudo journalctl -u mattermost -n 100
Amazon RDS와 Aurora는 DB 파라미터 그룹(RDS)과 DB 클러스터 파라미터 그룹(Aurora)을 통해 PostgreSQL 구성을 노출하므로 메모리, 복제 등의 설정을 조정할 수 있습니다. Aurora의 기본값은 대체로 대부분의 워크로드에 잘 맞춰져 있습니다. Amazon CloudWatch와 RDS Performance Insights 기능으로 성능을 모니터링하세요.
직접 관리하는 PostgreSQL
직접 관리하는 PostgreSQL 배포에서는 데이터베이스 구성을 전적으로 통제할 수 있으며, 복제, 백업, PostgreSQL 설정을 직접 구성해야 합니다.
PostgreSQL 복제 설정:
postgresql.conf를 편집해 주 데이터베이스 서버의 복제를 구성합니다.Ubuntu/Debian:
/etc/postgresql/{version}/main/postgresql.conf를 편집합니다(예:/etc/postgresql/14/main/postgresql.conf).RHEL/CentOS:
/var/lib/pgsql/{version}/data/postgresql.conf를 편집합니다(예:/var/lib/pgsql/14/data/postgresql.conf).# Enable replication wal_level = replica max_wal_senders = 10 max_replication_slots = 10 # Configure write-ahead log archiving (recommended) archive_mode = on archive_command = 'cp %p /var/lib/postgresql/wal_archive/%f'편집한 뒤에는 PostgreSQL을 재시작합니다.
sudo systemctl restart postgresql주 서버의
pg_hba.conf에서 복제 접근을 구성합니다.Ubuntu/Debian:
/etc/postgresql/{version}/main/pg_hba.conf를 편집합니다.RHEL/CentOS:
/var/lib/pgsql/{version}/data/pg_hba.conf를 편집합니다.# Allow replication connections from replica servers # Replace REPLICA_IP with your replica server IP addresses host replication replication_user REPLICA_IP/32 scram-sha-256주 서버에 복제 사용자를 생성합니다.
CREATE ROLE replication_user WITH REPLICATION LOGIN PASSWORD 'secure_password';pg_basebackup을 사용해 복제본을 생성합니다. 이 명령을 실행하기 전에 복제본에서 PostgreSQL을 중지하고 데이터 디렉터리가 비어 있는지 확인하세요.# On the replica server, create base backup from primary. # Replace DATA_DIR with the platform-specific data directory: # Ubuntu/Debian: /var/lib/postgresql/{version}/main # RHEL/CentOS: /var/lib/pgsql/{version}/data sudo -u postgres pg_basebackup -h PRIMARY_IP -D DATA_DIR -U replication_user -P -v -R -X stream-R플래그는standby.signal파일을 자동으로 생성하고 복제 설정을 구성합니다.복제본 서버를 시작합니다.
sudo systemctl start postgresql
sudo systemctl enable postgresql
주 서버에서 복제 상태를 확인합니다.
SELECT client_addr, state, sync_state FROM pg_stat_replication;
직접 관리하는 PostgreSQL용 Mattermost 구성:
mmctl 또는 환경 변수를 사용해 데이터베이스 연결을 구성합니다.
# Primary database connection
mmctl config set SqlSettings.DataSource "postgres://mattermost_user:password@primary-db.example.com:5432/mattermost?sslmode=require&connect_timeout=10"

# Read replica connections - create a configuration patch file
cat > /tmp/replica-config.json <<'EOF'
{
  "SqlSettings": {
    "DataSourceReplicas": [
      "postgres://mattermost_user:password@replica1-db.example.com:5432/mattermost?sslmode=require&connect_timeout=10",
      "postgres://mattermost_user:password@replica2-db.example.com:5432/mattermost?sslmode=require&connect_timeout=10"
    ]
  }
}
EOF

# Apply the replica configuration
mmctl config patch /tmp/replica-config.json

# Clean up the temporary file
rm /tmp/replica-config.json

# Connection pool settings
mmctl config set SqlSettings.MaxOpenConns 100
mmctl config set SqlSettings.MaxIdleConns 50
(이미 실행 중이라면) Mattermost를 재시작하지 않고 구성 변경을 적용합니다.
System Console > Environment > Web Server(시스템 콘솔 > 환경 > 웹 서버)로 이동해 Reload Configuration from Disk를 선택한 뒤, System Console > Environment > Database(시스템 콘솔 > 환경 > 데이터베이스)로 이동해 Recycle Database Connections를 선택합니다.
또는 Mattermost 서비스를 재시작합니다.
sudo systemctl restart mattermost
권장 PostgreSQL 설정:
다음 설정은 프로덕션 배포에 매우 중요합니다. AWS Aurora r5.xlarge 인스턴스에서 테스트했지만 비슷한 사양의 모든 PostgreSQL 배포에 적용할 수 있습니다.
주/라이터 노드 구성:
주 데이터베이스 서버에서 postgresql.conf를 편집합니다.
- Ubuntu/Debian:
/etc/postgresql/{version}/main/postgresql.conf - RHEL/CentOS:
/var/lib/pgsql/{version}/data/postgresql.conf
다음 설정을 추가하거나 수정합니다.
# Connection settings
# Adjust based on your hardware - this is for r5.xlarge or equivalent
# Coordinate with Mattermost MaxOpenConns setting
max_connections = 1024

# Random page cost - set to 1.1 for SSD storage
# Use default 4.0 for spinning disks
random_page_cost = 1.1

# Work memory - use 32MB with read replicas, 16MB for single instance
# Adjust downward for smaller instances
work_mem = 32MB

# Cache and buffer settings
# Set to 65% of total memory for dedicated database servers
# For 32GB RAM instance, use 21GB
# For smaller servers (e.g., 4GB RAM), use 20% or less (e.g., 512MB)
effective_cache_size = 21GB
shared_buffers = 21GB

# Maintenance work memory
# Use 1GB for 32GB+ RAM servers, 512MB for smaller servers
maintenance_work_mem = 1GB

# Autovacuum settings
autovacuum_max_workers = 4
autovacuum_vacuum_cost_limit = 500

# Parallel query settings (for servers with 32+ CPUs)
max_worker_processes = 12
max_parallel_workers_per_gather = 4
max_parallel_workers = 12
max_parallel_maintenance_workers = 4

# TCP keepalive settings
# If using pgbouncer or connection pooling proxy, apply these to the proxy
# and revert to defaults on the database
tcp_keepalives_idle = 5
tcp_keepalives_interval = 1
tcp_keepalives_count = 5
읽기 복제본 노드 구성:
각 읽기 복제본 서버에서 postgresql.conf를 편집해 위의 주 노드 설정을 모두 복사한 다음, 아래 항목을 수정하거나 추가합니다.
# Work memory - use 16MB on replicas, 32MB on primary
work_mem = 16MB

# Hot standby settings - CRITICAL FOR PRODUCTION STABILITY
# These settings prevent query cancellations when primary has write activity
# Without these settings, high write traffic can cause read queries to fail
hot_standby = on
hot_standby_feedback = on
hot_standby_feedback 설정은 프로덕션 안정성에 필수적입니다. 이 설정이 없으면 주 데이터베이스의 쓰기 트래픽이 많을 때 복제본이 장시간 실행되는 읽기 쿼리를 취소하여 애플리케이션 오류와 성능 저하로 이어질 수 있습니다.
주 서버나 복제본에서 구성 파일을 편집한 뒤에는 변경 사항이 적용되도록 PostgreSQL을 재시작합니다.
sudo systemctl restart postgresql
배큐밍과 유지·관리:
PostgreSQL 성능은 정기적인 배큐밍에 크게 좌우됩니다. 배큠 활동을 모니터링하세요.
-- Check vacuum status for top 10 tables with most dead tuples
SELECT relname, n_tup_ins as inserts, n_tup_upd as updates, n_tup_del as deletes,
       n_live_tup as live_tuples, n_dead_tup as dead_tuples, n_mod_since_analyze,
       last_autovacuum, last_autoanalyze, autovacuum_count, autoanalyze_count
FROM pg_stat_user_tables
ORDER BY dead_tuples DESC
LIMIT 10;
한 테이블에 데드 튜플이 50,000개를 넘거나 last_autovacuum을 보니 몇 달째 배큠되지 않았다면, 테이블별 autovacuum 설정을 조정하세요.
-- Example: More aggressive vacuuming for high-activity tables
ALTER TABLE posts SET (
  autovacuum_vacuum_scale_factor = 0.1,    -- default is 0.2
  autovacuum_analyze_scale_factor = 0.05,  -- default is 0.1
  autovacuum_vacuum_cost_limit = 1000      -- default is 200
);
모니터링 데이터를 바탕으로 이 값들을 조정하세요. PostgreSQL이 autovacuum 실행 시점을 계산하는 방식에 대한 자세한 내용은 PostgreSQL autovacuum 문서를 참고하세요.
검색 복제본
대규모 배포에서는 리소스를 많이 사용하는 검색 쿼리를 일반 데이터베이스 작업에서 분리하기 위해 전용 검색 복제본 구성을 고려하세요.
검색 복제본은 검색 쿼리를 전담하도록 Mattermost에서 구성한 PostgreSQL 읽기 복제본입니다.
# Configure dedicated search replicas - create a configuration patch file
cat > /tmp/search-replica-config.json <<'EOF'
{
  "SqlSettings": {
    "DataSourceSearchReplicas": [
      "postgres://mattermost_user:password@search-replica1.example.com:5432/mattermost?sslmode=require&connect_timeout=10",
      "postgres://mattermost_user:password@search-replica2.example.com:5432/mattermost?sslmode=require&connect_timeout=10"
    ]
  }
}
EOF

# Apply the search replica configuration
mmctl config patch /tmp/search-replica-config.json

# Clean up the temporary file
rm /tmp/search-replica-config.json
검색 복제본은 일반 읽기 복제본과 동일한 PostgreSQL 구성을 사용합니다. 구성하고 나면 모든 검색 쿼리가 검색 복제본에 분산됩니다. 검색 복제본을 사용할 수 없으면 쿼리는 읽기 복제본으로, 최종적으로는 주 데이터베이스로 폴백합니다.
고급 검색 기능이 필요한 배포는 Elasticsearch 연동에 대한 내용을 엔터프라이즈 검색에서 확인하세요.
데이터베이스 사이징
데이터베이스 사이징은 예상 사용자 수와 사용 패턴에 따라 달라집니다. 자세한 내용은 엔터프라이즈 배포(다중 서버) 하드웨어 요구 사항 문서를 참고하세요.
주요 고려 사항:
- 장애 조치 상황에서도 가용성을 확보할 수 있도록 주 데이터베이스와 복제본 데이터베이스가 각각 단독으로 100%의 부하를 감당할 수 있게 사양을 산정하세요
- 데이터베이스 CPU, 메모리, I/O 지표를 모니터링해 읽기 복제본을 추가해야 할 시점을 파악하세요
- 성장을 대비해 계획하세요. 데이터베이스 스토리지는 메시지 기록, 파일 메타데이터, 보존 정책에 따라 늘어납니다
데이터베이스 장애 조치와 재해 복구
수동 장애 조치:
유지·보수, 재해 복구 등 운영상의 필요로 읽기 복제본을 주 데이터베이스로 수동 승격해야 한다면 다음을 따르세요.
승격하기 전에 복제본이 동기화되었는지 확인하세요. 주 데이터베이스를 따라잡지 못한 복제본을 승격하면 재생되지 않은 WAL 데이터가 유실됩니다.
복제본 서버에서 복제 상태를 확인합니다.
SELECT pg_last_wal_receive_lsn(), pg_last_wal_replay_lsn(),
       pg_last_wal_replay_lsn() = pg_last_wal_receive_lsn() AS synced;
계속하기 전에
synced가true를 반환할 때까지 기다리세요. 주 데이터베이스에 이미 접근할 수 없는 계획되지 않은 장애 조치에서는, 이 확인이 데이터 유실이 전혀 없음을 보장하는 것이 아니라 주 데이터베이스가 실패하기 전에 무엇이 복제되었는지를 확인해 줄 뿐입니다.복제본을 주 데이터베이스로 승격합니다.
직접 관리하는 PostgreSQL의 경우:
# On the replica server.
# Replace DATA_DIR with the platform-specific data directory:
#   Ubuntu/Debian: /var/lib/postgresql/{version}/main
#   RHEL/CentOS: /var/lib/pgsql/{version}/data
sudo -u postgres pg_ctl promote -D DATA_DIR
Amazon RDS의 경우:
AWS 콘솔이나 CLI를 사용해 읽기 복제본을 독립 인스턴스로 승격합니다.
새 주 데이터베이스를 가리키도록 Mattermost 구성을 업데이트합니다.
# Update the DataSource to point to the new primary
mmctl config set SqlSettings.DataSource "postgres://user:password@new-primary.example.com:5432/mattermost?sslmode=require"
다운타임 없이 구성을 다시 로드합니다.
- System Console > Environment > Web Server(시스템 콘솔 > 환경 > 웹 서버)로 이동 → Reload Configuration from Disk
- System Console > Environment > Database(시스템 콘솔 > 환경 > 데이터베이스)로 이동 → Recycle Database Connections
연결이 재활용되는 동안 사용자는 (네트워크 끊김과 비슷한) 짧은 중단을 겪을 수 있습니다.
재해 복구:
포괄적인 재해 복구 계획을 위해 다음을 고려하세요.
pg_dump,pg_basebackup또는 관리형 백업 서비스를 사용해 정기적인 데이터베이스 백업을 구현합니다- 복원 절차를 정기적으로 테스트합니다
- 장애 조치 절차를 문서화하고 훈련합니다
- 지리적 중복성을 위해 리전 간 복제를 고려합니다(참고: 다중 리전 Mattermost 클러스터는 공식 지원되지 않지만, 네트워크를 적절히 구성하면 동작할 수 있습니다)
자세한 내용은 백업 및 재해 복구 문서를 참고하세요.
다음 단계
고가용성 클러스터를 배포해 운영하기 시작했다면, 배포 규모와 요구 사항에 따라 다음 추가 확장 최적화를 고려하세요.
Calls 배포
음성 및 화면 공유 통신에 Mattermost Calls를 사용한다면, HA 배포에 맞는 적절한 규모의 Calls 인프라를 계획하기 위해 Calls 자체 호스팅 배포를 검토하세요.
엔터프라이즈 검색
게시물이 250만 건을 넘을 것으로 예상되는 배포에서는 Elasticsearch를 사용하는 엔터프라이즈 검색 도입을 고려하세요. Elasticsearch는 대규모 배포에서 훨씬 빠른 검색 성능과 고급 검색 기능을 제공합니다.
Redis 연동
사용자 100,000명 이상을 지원하는 배포에서는 클러스터 전반의 세션 관리, 캐싱, 실시간 통신 성능을 개선하기 위해 Redis를 도입하세요.
성능 모니터링
고가용성 클러스터의 상태, 성능 지표, 리소스 사용률을 모니터링하려면 Prometheus와 Grafana를 배포하세요. 병목을 찾아내고 용량을 계획하며 최적의 성능을 유지하는 데 포괄적인 모니터링은 필수입니다.
운영과 유지·관리
이 섹션에서는 배포 이후 고가용성 클러스터를 관리하고 유지하는 운영 측면을 다룹니다.
클러스터 디스커버리
비표준(즉 복잡한) 네트워크 구성을 사용한다면, 클러스터 노드가 서로를 발견할 수 있도록 Override Hostname 설정을 사용해야 할 수 있습니다. 이 때문에 구성의 클러스터 설정은 구성 파일 해시에서 제외되며, 따라서 고가용성 모드에서 클러스터 구성 설정을 노드마다 조금씩 다르게 둘 수 있습니다. 디스커버리를 강제해야 한다면 Override Hostname은 클러스터 노드마다 다르게 설정하는 것이 의도된 사용 방식입니다.
UseIPAddress가 true로 설정되면, 첫 번째 비로컬 IP 주소(루프백, 로컬 유니캐스트, 로컬 멀티캐스트가 아닌 네트워크 인터페이스)를 찾아 IP 주소를 얻으려고 시도합니다. Go 내장 함수 net.InterfaceAddrs()로 네트워크 인터페이스를 열거합니다. 그렇지 않으면 Go 내장 함수 os.Hostname()으로 호스트 이름을 얻으려고 시도합니다.
데이터베이스에 대해 SELECT * FROM ClusterDiscovery를 실행하면 Hostname 필드가 어떻게 채워졌는지 확인할 수 있습니다. 이 필드는 서버가 클러스터의 다른 노드와 통신을 시도할 때 사용할 호스트 이름 또는 IP 주소입니다. Mattermost는 url Hostname:Port와 Hostname:PortGossipPort로 연결을 시도합니다. 클러스터가 gossip 통신을 올바르게 수행할 수 있도록 필요한 포트를 모두 열어 두어야 합니다. 이 포트들은 구성의 ClusterSettings 아래에 있습니다.
요약하면 다음과 같이 사용해야 합니다.
- 첫 번째 비로컬 주소를 다른 머신에서 볼 수 있다면 IP 주소 디스커버리를 사용합니다.
- 클러스터의 다른 노드가 제대로 발견할 수 있는 이름이 되도록 운영 체제에서 호스트 이름을 재정의합니다.
- 위 단계로 해결되지 않으면 서버 구성에서 Override Hostname을 사용합니다. 필요하다면 이 필드에 IP 주소를 넣을 수 있습니다.
config.json파일을 사용한다면 이 설정은 클러스터 노드마다 달라집니다.
상태
Mattermost 서버는 수평 확장이 가능하도록 상태를 거의 갖지 않게 설계되었습니다. Mattermost 확장 시 고려되는 상태 항목은 다음과 같습니다.
- 빠른 검증과 채널 접근을 위한 인메모리 세션 캐시.
- 빠른 응답을 위한 인메모리 온라인/오프라인 캐시.
- 메모리에 로드되어 저장되는 시스템 구성 파일.
- 메시지를 보내는 데 사용되는 클라이언트의 WebSocket 연결.
Mattermost 서버가 고가용성으로 구성되면, 서버들은 별도의 수신 주소에서 노드 간 통신 프로토콜을 사용해 상태를 동기화합니다. 상태가 변경되면 데이터베이스에 다시 기록되고 노드 간 메시지가 전송되어 다른 서버에 상태 변경을 알립니다. 항목의 실제 상태는 언제든 데이터베이스에서 읽을 수 있습니다. Mattermost는 "[사용자 X]님이 입력 중입니다" 같은 실시간 메시지를 위해 클러스터의 다른 서버로 WebSocket 메시지를 전달하는 데에도 노드 간 통신을 사용합니다.
리더 선출
클러스터 리더 선출 과정은 LDAP 동기화 같은 예약 작업이 다중 노드 클러스터 환경에서 단일 노드에서만 실행되도록 배정합니다.
이 과정은 널리 쓰이는 불리(bully) 리더 선출 알고리즘에 기반하며, 실패하지 않은 프로세스 중 노드 ID 번호가 가장 낮은 프로세스가 리더로 선택됩니다.
Mattermost v11.4부터 디버그 수준 로그 메시지를 통해 어느 노드가 특정 반복 작업(예약 게시물, 게시물 리마인더, DND 상태 초기화)을 실행하는지 파악할 수 있습니다. 리더가 아닌 노드는 Skipping scheduled posts job startup since this is not the leader node 같은 메시지를 기록해 해당 반복 작업의 실행을 리더에게 올바르게 넘기고 있음을 나타냅니다. 이는 오류가 아니라 정상적인 운영 메시지입니다. 이 디버그 메시지는 Elasticsearch 인덱싱, SAML 동기화, LDAP 동기화 같은 다른 작업 유형에는 적용되지 않습니다. 자세한 내용은 클러스터 작업 실행 디버그 메시지를 참고하세요.
잡 서버
Mattermost는 잡 서버를 통해 주기적인 작업을 실행합니다. 이러한 작업에는 다음이 포함됩니다.
- LDAP 동기화
- 데이터 보존
- 컴플라이언스 내보내기
- Elasticsearch 인덱싱
- 예약 게시물
- DND 상태 초기화
- 게시물 리마인더
클러스터의 모든 앱 서버와 잡 서버에서 JobSettings.RunScheduler를 true로 설정했는지 확인하세요. 그러면 클러스터 리더가 반복 작업 예약을 담당합니다.
mmctl로 이 설정을 확인할 수 있습니다.
mmctl config get JobSettings.RunScheduler
설정해야 한다면 다음과 같이 합니다(기본값은 true입니다).
mmctl config set JobSettings.RunScheduler true
- 이 설정을 기본값인
true에서 바꾸지 말 것을 강력히 권장합니다. 값을 바꾸면ClusterLeader가 스케줄러를 실행할 수 없게 됩니다. 그 결과 LDAP 동기화, 컴플라이언스 내보내기, 데이터 보존 같은 반복 작업이 더 이상 예약되지 않습니다. 이전 Mattermost 서버 버전과 이 문서에서는 잡 서버를RunScheduler: false로 실행하라고 안내했습니다. 클러스터 설계가 발전하면서 이제는 그렇지 않습니다. - Mattermost v11.4부터 디버그 로깅을 활성화하면 반복 작업(예약 게시물, 게시물 리마인더, DND 상태 초기화)이 올바른 노드에서 실행되는지 확인할 수 있습니다. 리더가 아닌 노드는 이 특정 반복 작업의 실행을 건너뛴다는 메시지를 기록하며, 이는 예상된 동작입니다. 이 디버그 메시지는 다른 작업 유형에는 적용되지 않습니다. 자세한 내용은 클러스터 작업 실행 디버그 메시지를 참고하세요.
플러그인과 고가용성
플러그인을 설치하거나 업그레이드하면 클러스터의 서버 전체로 자동 전파됩니다. 파일 스토리지는 NAS나 Amazon S3 같은 서비스를 통해 모든 서버가 공유하는 것으로 가정합니다.
"DriverName": "local"을 사용한다면 "FileSettings":의 "Directory": "./data/" 디렉터리는 로컬 디렉터리로 매핑된 NAS 위치여야 합니다. 그렇지 않으면 고가용성이 올바르게 동작하지 않고 파일 스토리지가 손상될 수 있습니다.
v5.14에서 플러그인을 다시 설치하면 이전의 Enabled 또는 Disabled 상태가 유지됩니다. v5.15부터는 다시 설치한 플러그인의 초기 상태가 Disabled입니다.
CLI와 고가용성
CLI는 단일 노드에서 실행되므로 고가용성 환경이 클러스터의 모든 노드에 걸쳐 작업을 수행하기 위해 사용하는 메커니즘을 우회합니다. 그 결과 고가용성 환경에서 CLI 명령을 실행할 때는 사용자 업데이트·삭제나 설정 변경 같은 작업에 서버 재시작이 필요합니다.
고가용성 환경에서는 서버 재시작이 필요 없는 mmctl 사용을 권장합니다. 변경은 API 계층을 통해 이루어지므로, 변경 요청을 받은 노드가 클러스터의 다른 모든 노드에 알립니다.
업그레이드 가이드
업데이트는 버그나 성능 문제를 고치는 Mattermost 서버의 점진적 변경입니다. 업그레이드는 서버에 새로운 기능이나 개선된 기능을 추가합니다.
고가용성과 Active/Active 지원을 위해 Kubernetes에서 배포를 안전하게 업그레이드하는 방법은 Kubernetes 및 고가용성 환경에서 Mattermost 업그레이드 문서를 참고하세요.
무중단 운영 중 구성 변경 적용
대부분의 구성 업데이트에는 서비스 중단이 필요하지 않습니다. 서비스 중단이 필요한 업그레이드에 대한 자세한 내용은 아래 섹션을 참고하세요. 부하가 적은 시간대에 업데이트를 적용할 수 있지만, 고가용성 클러스터 기반 배포의 사양이 적절히 산정되어 있다면 언제든 적용할 수 있습니다. 시스템 다운타임은 짧으며 클러스터의 Mattermost 서버 수에 따라 달라집니다. 머신을 재시작하는 것이 아니라 Mattermost 서버 애플리케이션만 재시작한다는 점에 유의하세요. Mattermost 서버 재시작에는 보통 약 5초가 걸립니다.
데이터베이스 구성을 사용하는 경우(권장):
mmctl을 사용해 설정을 업데이트합니다. 변경 사항은 클러스터의 모든 서버로 자동 전파됩니다.
mmctl config set <setting> <value>
예시:
mmctl config set TeamSettings.MaxUsersPerTeam 100
config.json 파일을 사용하는 경우:
config.json 파일을 사용할 때는 시스템 콘솔로 설정을 변경하지 마세요. 그렇게 하면 고가용성 클러스터 기반 배포에서 두 서버의 구성 파일이 달라져, 사용자가 다른 앱 서버에 연결할 때마다 화면이 새로 고쳐집니다.
- 기존
config.json파일을 백업합니다. - Mattermost 서버 중 한 대에서
config.json에 구성 변경을 적용하고 파일을 저장합니다. 아직 파일을 다시 로드하지는 마세요. config.json파일을 다른 서버로 복사합니다.- 한 대를 제외한 모든 서버에서 Mattermost를 종료합니다.
- 계속 실행 중인 서버에서 구성 파일을 다시 로드합니다. System Console > Environment > Web Server(시스템 콘솔 > 환경 > 웹 서버)로 이동해 Reload Configuration from Disk를 선택합니다.
- 다른 서버들을 시작합니다.
무중단 운영 중 서버 버전 업데이트
Mattermost 서버의 보안 패치 닷 릴리스에는 서비스 중단이 필요하지 않습니다. 업데이트 중 서버 한 대가 시스템 전체 부하를 감당할 수 있을 만큼 예상 부하가 작은 시간대에 업데이트를 적용할 수 있습니다.
Mattermost는 롤링 업그레이드를 수행할 때 서버 버전 간 마이너 버전 차이를 하나까지 지원합니다(예: v11.4.1 + v11.4.2 또는 v11.3.2 + v11.4.2는 지원되지만 v11.1.3 + v11.4.0은 지원되지 않습니다). 업그레이드 상황이 아니라면 클러스터에서 서로 다른 두 버전의 Mattermost를 운영해서는 안 됩니다.
재시작할 때는 머신을 재시작하는 것이 아니라 Mattermost 서버 애플리케이션만 재시작합니다. Mattermost 서버 재시작에는 보통 약 5초가 걸립니다.
- Mattermost 서버 업그레이드의 Upgrade Enterprise Edition 섹션에서 업그레이드 절차를 검토합니다.
- Mattermost 데이터베이스를 백업합니다. 구성에
config.json파일을 사용한다면 구성 파일도 백업합니다. - 모든 새 요청이 서버 한 대로 가도록 프록시를 설정합니다. NGINX를 사용하고
/etc/nginx/sites-available/mattermost에 upstream backend 섹션이 구성되어 있다면, 먼저 업데이트할 서버 한 대만 남기고 나머지를 주석 처리한 뒤 NGINX를 다시 로드합니다. - 먼저 업데이트할 서버를 제외한 각 서버에서 Mattermost를 종료합니다.
- 종료한 각 Mattermost 인스턴스를 업데이트합니다.
config.json파일을 사용한다면 각 서버의 새config.json파일을 백업해 둔 사본으로 교체합니다.- Mattermost 서버들을 시작합니다.
- 계속 실행 중이던 서버에 대해 업데이트 절차를 반복합니다.
서비스 중단이 필요한 서버 업그레이드
업그레이드에 데이터베이스 스키마 변경이 포함되거나, 다음과 같이 서버 구성 변경에 서버 재시작이 필요한 경우에는 서비스 중단이 필요합니다.
- 기본 서버 언어
- 속도 제한(Rate limiting)
- 웹서버 모드
- 데이터베이스
- 고가용성
업그레이드에 데이터베이스 스키마 변경이 포함되어 있다면, 가장 먼저 시작하는 서버가 데이터베이스를 업그레이드합니다.
부하가 적은 시간대에 업그레이드를 적용하세요. 시스템 다운타임은 짧으며 클러스터의 Mattermost 서버 수에 따라 달라집니다. 머신을 재시작하는 것이 아니라 Mattermost 서버 애플리케이션만 재시작한다는 점에 유의하세요.
- Mattermost 서버 업그레이드의 Upgrade Enterprise Edition 섹션에서 업그레이드 절차를 검토합니다.
- Mattermost 데이터베이스를 백업합니다. 구성에
config.json파일을 사용한다면 구성 파일도 백업합니다. - NGINX를 중지합니다.
- 각 Mattermost 인스턴스를 업그레이드합니다.
config.json파일을 사용한다면 각 서버의 새config.json파일을 백업해 둔 사본으로 교체합니다.- Mattermost 서버 중 한 대를 시작합니다.
- 해당 서버가 실행되면 나머지 서버들을 시작합니다.
- NGINX를 재시작합니다.
모든 클러스터 노드는 단일 프로토콜을 사용해야 합니다
모든 클러스터 트래픽은 gossip 프로토콜을 사용합니다. gossip 클러스터링은 더 이상 비활성화할 수 없습니다.
고가용성 클러스터 기반 배포를 업그레이드할 때, 한 노드가 gossip 프로토콜을 사용하지 않고 있으면 클러스터의 다른 노드를 업그레이드할 수 없습니다. 이런 유형의 업그레이드를 완료하려면 gossip을 사용해야 합니다. 그렇지 않으면 모든 노드를 종료한 뒤 업그레이드 후 개별적으로 다시 올릴 수 있습니다.
무중단 운영 요구 사항
서버 업데이트와 업그레이드를 포함해 언제나 무중단 운영이 가능하려면, 중복 구성 요소의 사양이 적절히 산정되어 있어야 하고 시스템 각 구성 요소를 올바른 순서로 업데이트해야 합니다.
- 예상 규모에서의 중복성
- 한 구성 요소에 장애가 발생하면 남은 애플리케이션 서버, 데이터베이스 서버, 로드 밸런서가 시스템의 전체 부하를 감당할 수 있도록 사양이 산정되고 구성되어 있어야 합니다. 이 요건을 충족하지 못하면 한 구성 요소의 장애가 나머지 구성 요소의 과부하로 이어져 시스템 전체가 중단될 수 있습니다.
- 무중단 운영을 위한 업데이트 순서
시스템 구성 요소를 올바른 순서로 업데이트한다면 대부분의 구성 변경과 닷 릴리스 보안 업데이트는 서비스를 중단하지 않고 적용할 수 있습니다. 방법은 업그레이드 가이드를 참고하세요.
예외: 서버 재시작이 필요한 설정 변경과 데이터베이스 스키마 변경이 수반되는 서버 버전 업그레이드에는 짧은 다운타임이 필요합니다. 서버 재시작에 따른 다운타임은 약 5초입니다. 데이터베이스 스키마 업데이트의 경우 다운타임이 최대 30초까지 발생할 수 있습니다.
Mattermost는 여러 데이터센터에 걸친 고가용성 배포를 지원하지 않습니다. 올바른 동작과 성능을 보장하려면 고가용성 클러스터의 모든 노드가 동일한 데이터센터 안에 있어야 합니다.
자주 묻는 질문(FAQ)
Mattermost는 다중 리전 고가용성 클러스터 기반 배포를 지원하나요?
지원합니다. 공식적으로 테스트하지는 않았지만, 예를 들어 AWS 리전에 걸쳐 클러스터를 구성할 수 있으며 문제없이 동작할 것입니다.
데이터베이스 재해 복구에는 무엇을 권장하나요?
Mattermost를 고가용성 구성으로 배포할 때는 Mattermost와 데이터베이스 사이에 데이터베이스 로드 밸런서를 두는 것을 권장합니다. 배포 형태에 따라 고려해야 할 사항의 정도가 달라집니다.
예를 들어 Amazon Aurora와 함께 AWS에 Mattermost를 배포한다면 여러 가용 영역을 활용할 것을 권장합니다. 자체 클러스터에 Mattermost를 배포한다면 기존 아키텍처에 가장 적합한 솔루션을 IT 팀과 상의하세요.
연결된 웹소켓의 호스트 이름은 어떻게 확인하나요?
Mattermost v10.4부터 자체 호스팅 배포를 운영하는 Enterprise 고객은 Product(제품) 메뉴  에서 About Mattermost를 선택해 Mattermost를 실행 중인 클러스터 노드의 호스트 이름을 확인할 수 있습니다.
문제 해결
고가용성 문제 해결 데이터 수집
Mattermost를 고가용성 구성으로 배포할 때는 Prometheus·Grafana 지표와 클러스터 서버 로그를 가능한 한 오래, 최소 2주 이상 보관할 것을 권장합니다.
분석과 문제 해결을 위해 이 데이터를 Mattermost에 제공해 달라는 요청을 받을 수 있습니다.
- 서버 로그 파일이 생성되고 있는지 확인하세요. Mattermost 로그를 다루는 방법은 여기에서 자세히 확인할 수 있습니다.
- 문제를 조사하고 재현할 때는 System Console > Environment > Logging(시스템 콘솔 > 환경 > 로깅)을 열고 File Log Level을 DEBUG로 설정해 더 완전한 로그를 남길 것을 권장합니다. 디스크 공간을 아끼려면 문제 해결 후 반드시 INFO로 되돌리세요.
- 각 서버는 자체 서버 로그 파일을 갖고 있으므로, 고가용성 클러스터 기반 배포의 모든 서버에 대한 서버 로그를 제공해야 합니다.
빨간색 서버 상태
고가용성 모드가 활성화되면 시스템 콘솔은 서버가 클러스터와 올바르게 통신하고 있는지를 나타내기 위해 서버 상태를 빨간색 또는 초록색으로 표시합니다. 서버들은 노드 간 통신으로 클러스터의 다른 머신에 핑을 보내고, 핑이 성립되면 서버 버전과 구성 파일 같은 정보를 교환합니다.
서버 상태가 빨간색이 되는 원인은 다음과 같습니다.
- 구성 파일 불일치: Mattermost는 여전히 노드 간 통신을 시도하지만, 고가용성 모드 기능은 모든 서버가 동일한 구성 파일을 사용한다고 가정하므로 시스템 콘솔은 해당 서버를 빨간색 상태로 표시합니다.
- 서버 버전 불일치: Mattermost는 여전히 노드 간 통신을 시도하지만, 고가용성 모드 기능은 클러스터의 각 서버에 동일한 버전의 Mattermost가 설치되어 있다고 가정하므로 시스템 콘솔은 해당 서버를 빨간색 상태로 표시합니다. 모든 서버에서 최신 버전의 Mattermost를 사용할 것을 권장합니다. 업그레이드가 필요한 서버에는 Mattermost 서버 업그레이드의 업그레이드 절차를 따르세요.
- 서버 다운: 노드 간 통신에서 메시지 전송에 실패하면 15초 후 다시 시도합니다. 두 번째 시도도 실패하면 해당 서버가 다운된 것으로 간주합니다. 오류 메시지가 로그에 기록되고 시스템 콘솔은 그 서버를 빨간색 상태로 표시합니다. 노드 간 통신은 15초 간격으로 다운된 서버에 계속 핑을 보냅니다. 서버가 다시 올라오면 새 메시지가 그 서버로 전송됩니다.
WebSocket 연결 끊김
클라이언트 WebSocket이 연결 끊김을 받으면 백오프를 적용해 3초마다 자동으로 재연결을 시도합니다. 연결이 성립되면 클라이언트는 끊겨 있는 동안 전송된 메시지를 받으려고 시도합니다.
앱이 계속 새로 고쳐짐
구성에 config.json 파일을 사용할 때 시스템 콘솔로 설정을 변경하면, 사용자가 다른 앱 서버에 연결할 때마다 클라이언트가 새로 고쳐집니다. 고가용성 클러스터 기반 배포에서 서버들의 구성 파일이 서로 달라졌기 때문에 발생합니다.
해결 방법:
- 데이터베이스 구성을 사용한다면(권장) 시스템 콘솔이나 mmctl로 설정을 변경하세요. 변경 사항이 모든 서버에 자동으로 동기화됩니다.
config.json파일을 사용한다면 다음 단계에 따라 파일에서 직접 설정을 변경하세요.
다시 로드해야만 메시지가 게시됨
고가용성 모드로 운영할 때는 모든 Mattermost 애플리케이션 서버가 동일한 버전의 Mattermost를 실행하고 있는지 확인하세요. 서로 다른 버전을 실행하면 낮은 버전의 앱 서버가 요청을 처리하지 못해, 프런트엔드 애플리케이션이 새로 고쳐지고 유효한 Mattermost 버전의 서버로 전송될 때까지 요청이 전달되지 않는 상태가 될 수 있습니다. 요청이 무작위로 실패하는 것처럼 보이거나, 특정 애플리케이션 서버 한 대에서 고루틴과 API 오류가 급격히 늘어나는 증상을 살펴보세요.