
성능 알림 가이드
Entry, Enterprise, Enterprise Advanced 플랜에서 사용할 수 있습니다(Professional에서는 제공되지 않습니다).
Mattermost는 Mattermost 애플리케이션 서버의 성능 지표를 추적하기 위해 Prometheus와 Grafana 사용을 권장합니다. 이 가이드는 시스템 상태 추적을 설정한 뒤 Grafana 대시보드에 알림을 구성하는 것을 돕기 위한 문서입니다.
성능 부하 분산을 위해 서버를 추가한 5,000명 이상 규모의 배포 환경에서는 성능 알림을 설정할 것을 적극 권장합니다.
사전 요구 사항
Mattermost의 성능 모니터링을 설정합니다. 자세한 내용은 성능 모니터링 문서를 참고하세요.
알림을 받으려면 먼저 Grafana에서 Notification Channel을 설정해야 합니다. Mattermost에 알림을 자동으로 게시하도록 설정하는 방법은 다음과 같습니다.
- Mattermost에서:
- Alerts 채널을 만듭니다.
- Alerts 채널용 인커밍 웹훅을 만들고 URL을 복사합니다.
- Grafana에서:
- 사이드바의 알림 아이콘 아래에서 Contact points를 선택합니다.
- Create contact point를 선택합니다.
- 이름으로 Mattermost Alerts Channel을 입력합니다.
- 유형(type)으로 Slack을 선택합니다.
- 웹훅 URL을 URL 필드에 붙여 넣습니다.
- 알림이 Mattermost에 게시될 때 멘션을 보내고 싶다면 멘션 필드에 @ 멘션을 포함합니다.
- Send Test를 눌러 알림을 테스트합니다.
이메일 알림도 받고 싶다면 이 안내에 따라 설정할 수 있습니다.
알림 구성
Grafana용 Mattermost 대시보드에는 다음 차트에 대해 일부 사전 구성된 알림이 포함되어 있습니다.
- CPU Utilization Rate
- Memory Usage
- Number of Goroutines
- Number of API Errors per Second
- Mean API Request Time
알림을 구성하려면 적절한 임계값을 설정하고 알림 발송을 활성화하세요. 알림 발송 활성화 방법은 모든 차트에서 동일하지만, 올바른 임계값을 설정하는 방법은 차트별로 차이가 있으므로 차트마다 개별적으로 다루는 편이 낫습니다.
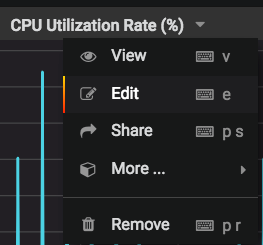
- 각 차트에서 차트 이름을 선택한 뒤 Edit를 선택합니다.
- Alert 탭을 선택합니다.
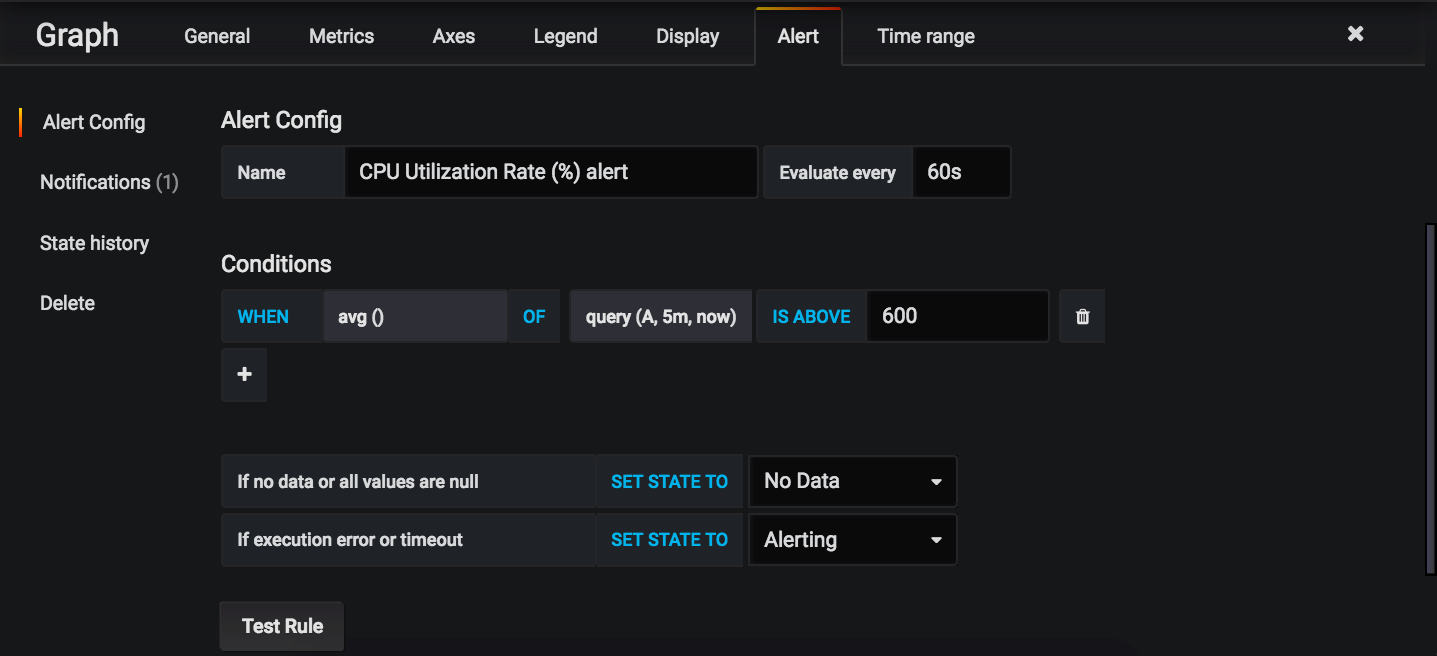
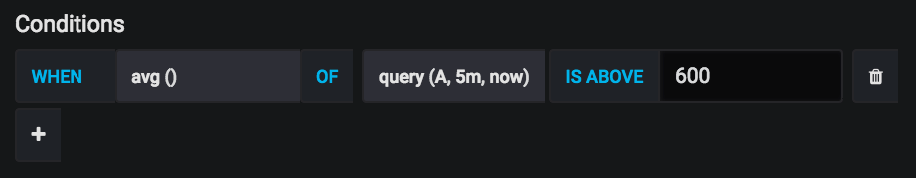
- 아래 섹션들에서 다룰 알림 임계값은 Conditions 아래 마지막 필드입니다(위 스크린샷에서 600으로 설정된 항목).
각 차트의 임계값을 설정하는 방법은 아래 섹션들을 참고하세요. 직접 만든 알림 조건을 추가하고 싶다면 여기에서 구성하면 됩니다.
- 알림 발송을 활성화하려면 왼쪽의 Notification 탭을 선택한 뒤 Send to 아래에서 Mattermost Alerts Channel을 선택합니다.
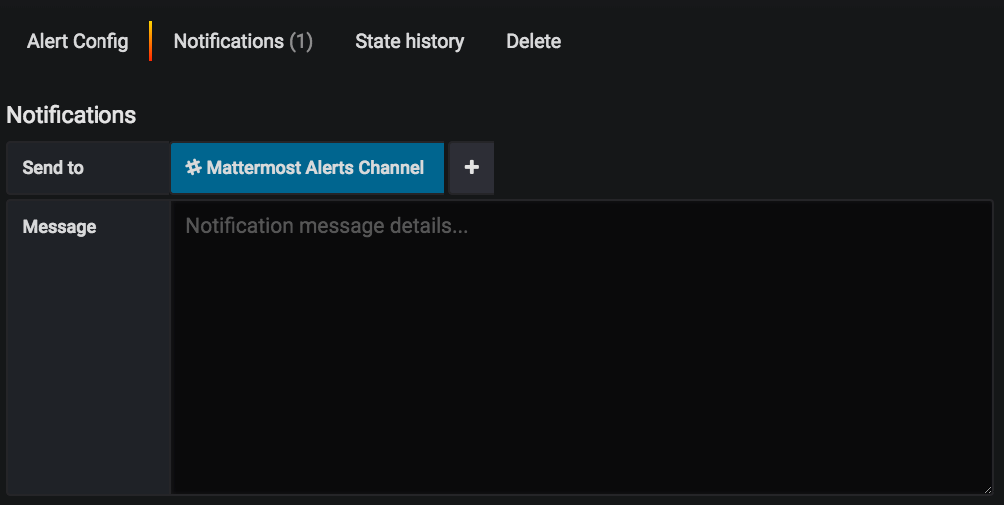
알림에 맥락을 더하고 싶다면 메시지를 입력하세요.
기본적으로 알림은 최근 1분간 차트의 평균값이 임계값을 초과하는지 확인하도록 구성되어 있습니다. 임계값을 초과하면 알림이 발생합니다. 최근 1분간의 평균이므로 임계값을 잠깐 넘는 작은 급증만으로는 반드시 알림이 발생하지는 않습니다. 이는 자연스러운 사용량 급증으로 인한 오탐을 방지하는 데 도움이 됩니다. 각 차트의 알림 상태는 1분마다 평가됩니다.
사용 가능한 차트
아래 섹션들에서 각 차트를 더 자세히 설명합니다.
CPU 사용률
CPU Utilization Rate는 비교적 단순한 지표입니다. CPU Utilization Rate는 앱 서버의 CPU 사용량을 백분율로 추적합니다. 최대 백분율은 앱 서버가 보유한 CPU 코어 또는 vCPU 수에 따라 결정됩니다. 예를 들어 CPU 코어가 4개이고 앱 서버가 4개 코어 모두에서 100% 사용률을 보인다면, 그래프에는 해당 앱 서버가 400%로 표시됩니다.
알림 임계값은 평균 CPU 사용률과 앱 서버가 보유한 코어/vCPU 수를 기준으로 설정하는 것이 가장 좋습니다. 최근 7일간의 차트를 살펴보세요. 최대 CPU 사용량(코어 수 × 100)과 실제로 관측되는 CPU 사용량 사이의 어느 지점으로 임계값을 설정하는 것이 좋습니다. 임계값을 낮게 설정할수록 알림이 많아지고 따라서 오탐도 늘어납니다. 임계값을 너무 높게 설정하면 상황이 더 악화될 때까지 장애 알림을 받지 못할 수 있습니다. 같은 원리가 차트와 무관하게 모든 알림에 적용됩니다.
예를 들어 Mattermost 커뮤니티 서버에서는 임계값을 15%로 설정해 두었습니다.
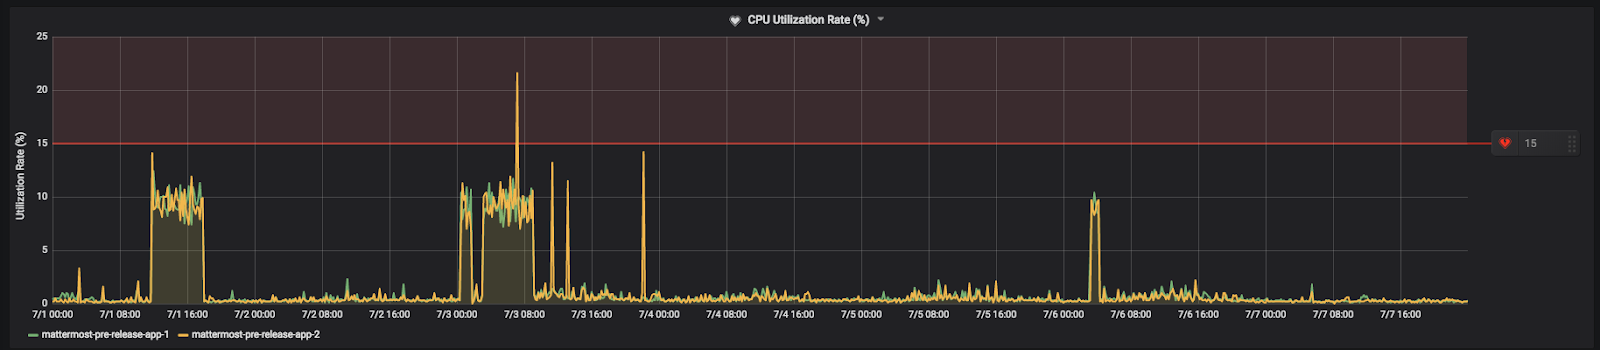
이 값은 최대 CPU 사용량보다는 낮고 피크 시간대의 평균 사용량보다는 높습니다. 따라서 비정상적으로 높은 CPU 사용량이 발생하기 시작하면 알림을 받게 됩니다.
메모리 사용량
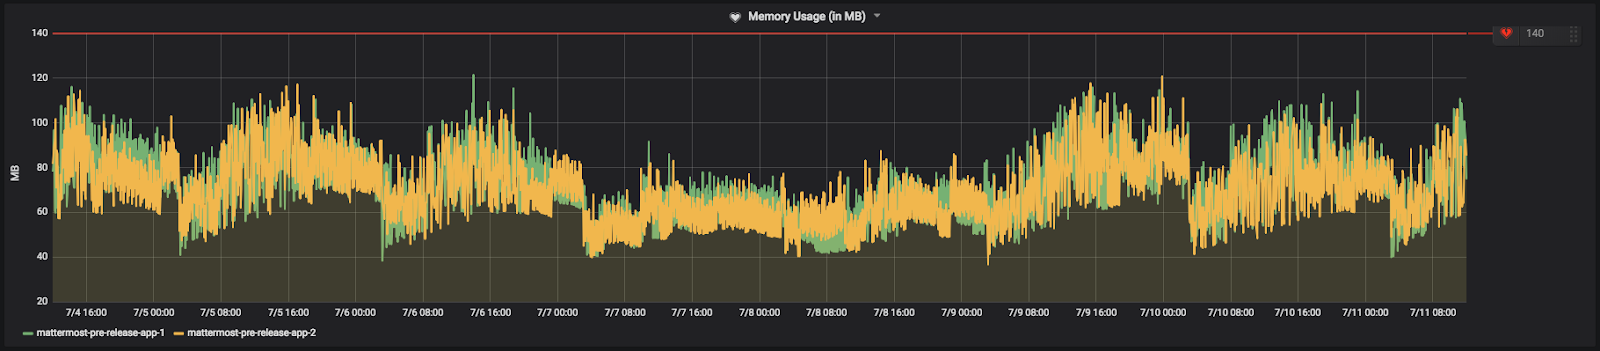
Memory Usage는 앱 서버가 사용 중인 RAM을 메가바이트 단위로 추적합니다. 임계값은 CPU Utilization Rate와 비슷하게, 사용 가능한 최대 메모리보다는 낮고 피크 시간대의 평균 사용량보다는 높게 설정하세요.
커뮤니티 서버에 설정해 둔 알림은 다음과 같습니다.
고루틴 수
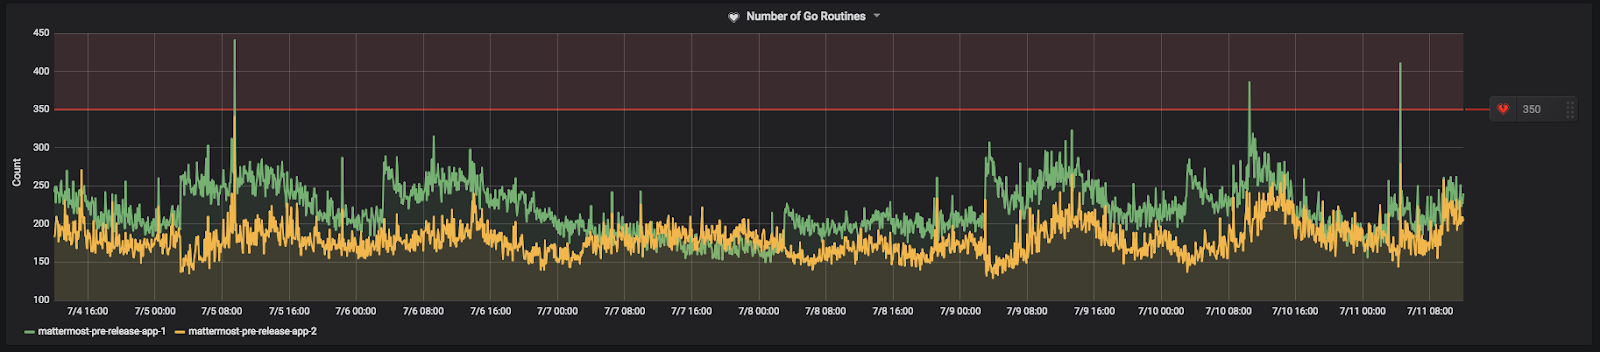
고루틴(goroutine)은 다른 함수·메서드와 동시에 실행되는 함수 또는 메서드입니다. 고루틴은 생성 비용이 낮은 경량 스레드와 비슷합니다. 고루틴 수의 증가는 앱 서버 성능을 가늠하는 좋은 척도가 될 수 있습니다. 지속적으로 증가한다는 것은 앱 서버가 부하를 감당하지 못하고, 고루틴이 작업을 마치고 종료되는 속도보다 빠르게 생성되고 있다는 뜻입니다.
임계값은 피크 부하 시간대에 관측되는 평균 고루틴 수보다 다소 높게 설정하세요. 작은 급증은 보통 걱정할 필요가 없습니다. 주의해야 할 것은 고루틴이 통제되지 않고 계속 증가하는 상황입니다.
커뮤니티 서버에 설정해 둔 값은 다음과 같습니다.
초당 API 오류 수
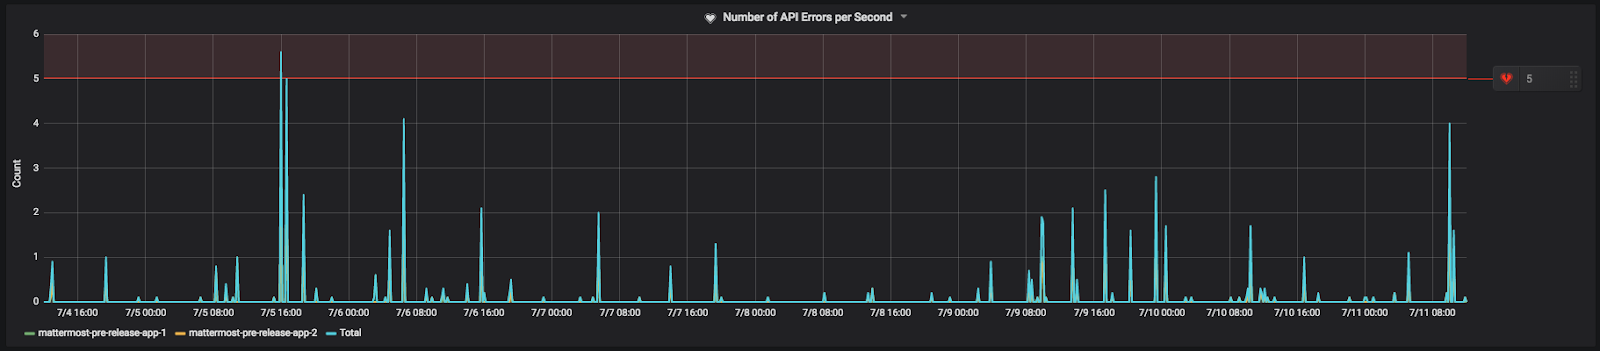
4xx 또는 5xx HTTP 응답 상태 코드는 모두 REST API 오류로 집계됩니다. API 오류 자체가 반드시 문제인 것은 아닙니다. 사용자 세션 만료나, 클라이언트가 리소스 존재 여부를 확인하다가 404 Not Found 응답을 받는 경우처럼 API 오류가 발생하는 정당한 이유는 많습니다. 설치 규모에 비례해 어느 정도의 API 오류가 발생하는 것은 정상입니다.
그렇지만 REST API에 대한 오류는 배포 문제나 그 밖의 문제를 나타낼 수 있습니다. 예를 들어 어떤 이유로든 앱 서버 중 하나가 제대로 배포되지 않으면 다수의 API 오류를 반환하기 시작할 수 있습니다. 또 다른 예로는 잘못된 요청으로 API를 도배하는 비정상 봇이 있습니다. 초당 API 오류 수에 대한 알림은 이런 문제를 비롯한 여러 문제를 포착하는 데 도움이 됩니다.
커뮤니티 서버에 설정해 둔 값은 다음과 같습니다.
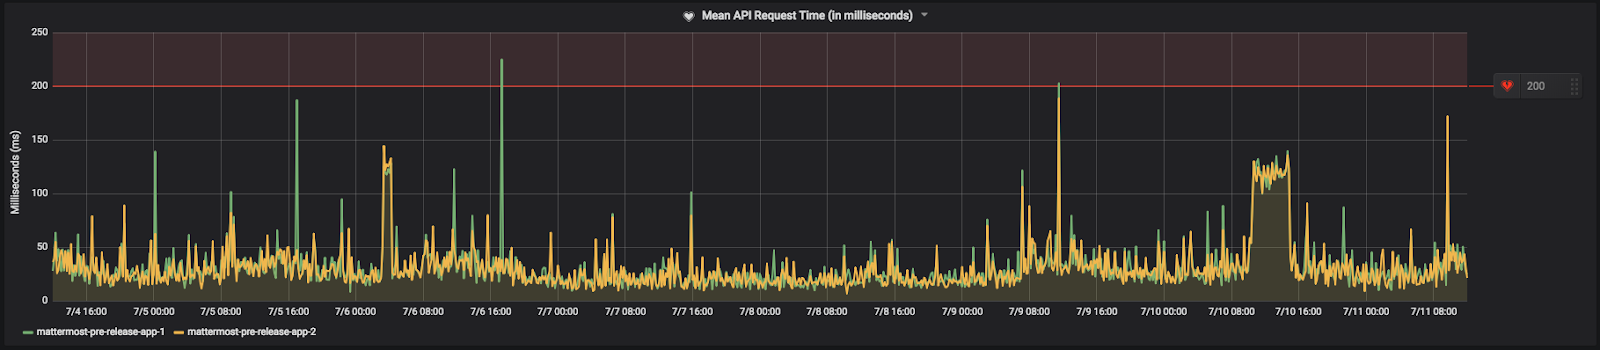
평균 API 요청 시간
Mean API Request Time은 Mattermost 앱 서버에 대한 REST API 요청이 완료되기까지 걸리는 평균 시간입니다. 앱 서버의 성능이 저하되기 시작하면 요청 완료에 더 오랜 시간이 걸리면서 평균 요청 시간이 상승하는 것을 보게 될 가능성이 큽니다. 데이터베이스가 앱 서버에서 오는 부하를 감당하지 못하는 경우에도 이런 현상이 나타날 수 있습니다. 앱 서버와 프록시 사이의 문제를 나타내는 것일 수도 있습니다.
알림 임계값은 피크 부하 시간대의 평균 요청 시간보다 조금 높게 설정하는 것이 좋습니다.
커뮤니티 서버에 설정해 둔 값은 다음과 같습니다.
플러그인 훅
Prometheus로 훅과 플러그인 API 호출을 추적할 수 있습니다. 아래는 서버 성능을 문제 해결하거나 모니터링할 때 알아 두면 좋은 훅 및 API Prometheus 지표의 예시입니다.
# HELP mattermost_plugin_hook_time Time to execute plugin hook handler in seconds.
# TYPE mattermost_plugin_hook_time histogram
mattermost_plugin_hook_time_bucket{hook_name="ChannelHasBeenCreated",plugin_id="com.mattermost.demo-plugin",success="true",le="0.005"} 0
mattermost_plugin_hook_time_bucket{hook_name="ChannelHasBeenCreated",plugin_id="com.mattermost.demo-plugin",success="true",le="0.01"} 0
# HELP mattermost_plugin_multi_hook_time Time to execute multiple plugin hook handler in seconds.
# TYPE mattermost_plugin_multi_hook_time histogram
mattermost_plugin_multi_hook_time_bucket{plugin_id="com.mattermost.custom-attributes",le="0.005"} 100
mattermost_plugin_multi_hook_time_bucket{plugin_id="com.mattermost.custom-attributes",le="0.01"} 100
# HELP mattermost_plugin_multi_hook_server_time Time for the server to execute multiple plugin hook handlers in seconds.
# TYPE mattermost_plugin_multi_hook_server_time histogram
mattermost_plugin_multi_hook_server_time_bucket{le="0.005"} 1043
# HELP mattermost_plugin_api_time Time to execute plugin API handlers in seconds.
# TYPE mattermost_plugin_api_time histogram
mattermost_plugin_api_time_bucket{api_name="AddUserToChannel",plugin_id="com.mattermost.plugin-incident-response",success="true",le="0.005"} 0
mattermost_plugin_api_time_bucket{api_name="AddUserToChannel",plugin_id="com.mattermost.plugin-incident-response",success="true",le="0.01"} 0
그 밖의 알림
알림을 더 추가하고 싶다면 원하는 Grafana 차트 어디에나 설정할 수 있습니다. 성능 모니터링 기능 문서에 정리된 맞춤 지표를 검토해 볼 것을 권장합니다.